让 AI 根据公司资料回答,RAG 是怎么做到的?
AI 怎么根据公司资料回答问题?用 RAG 讲清资料准备、检索、生成,以及向量检索、关键词检索和混合检索怎么选。
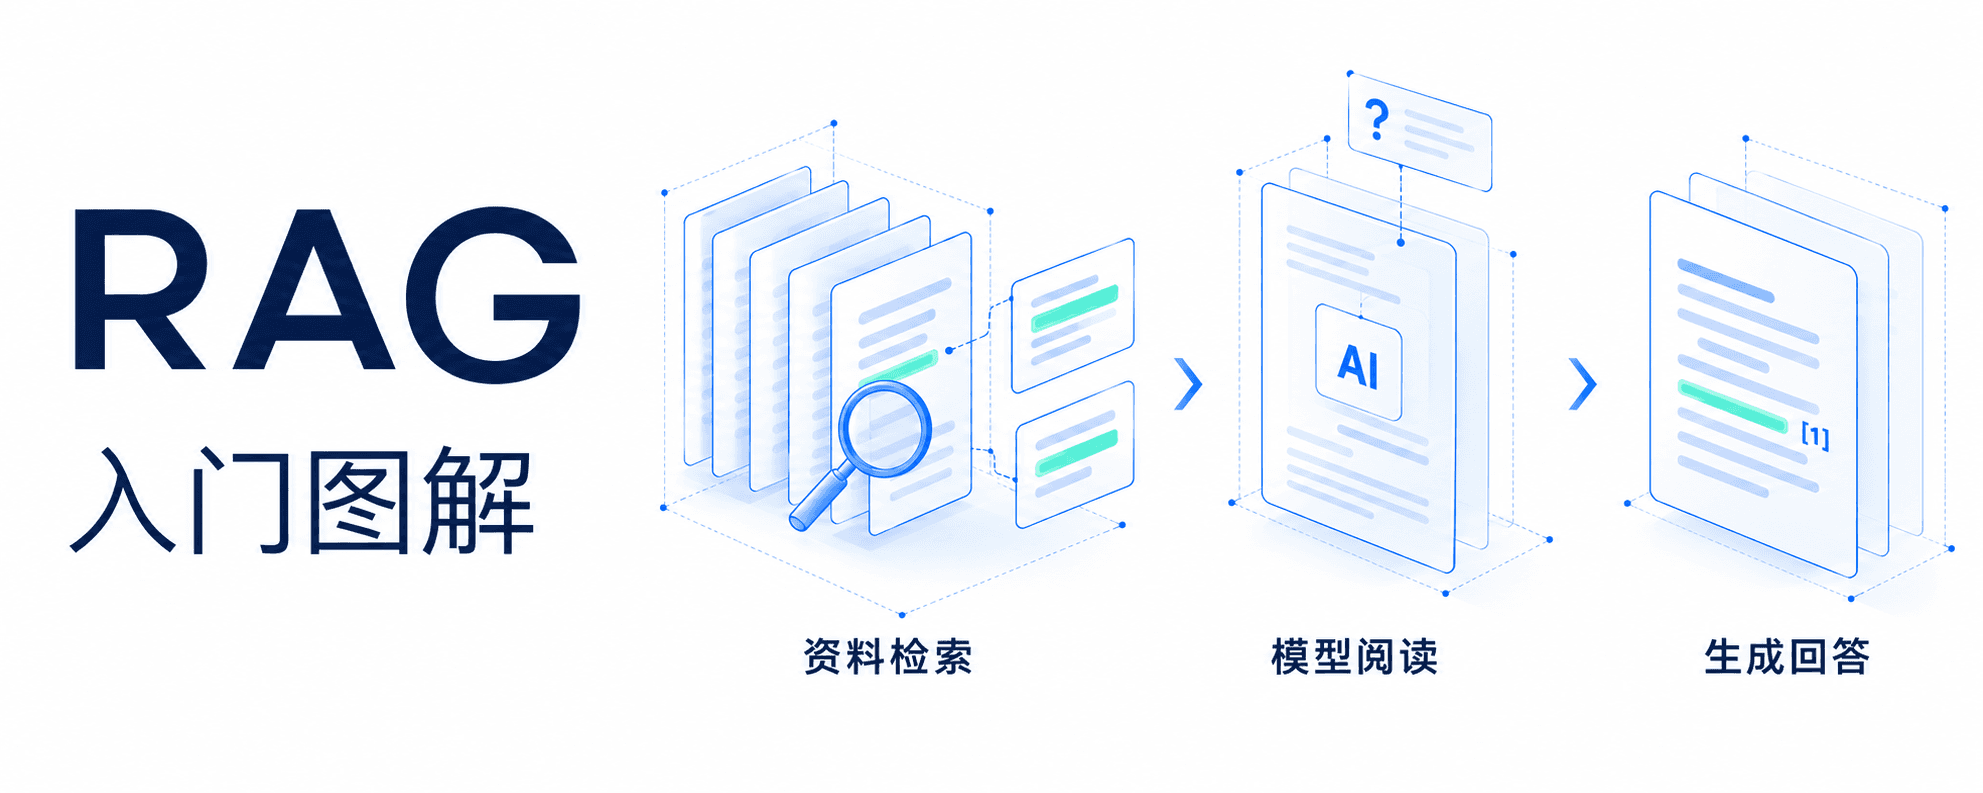
ChatGPT 很会聊天,但问它公司内部规定,它通常答不上来。
不是模型不够聪明,而是它没有看过这些资料。
一种常见做法是:把公司文档交给系统。用户提问后,系统先找出相关内容,再让模型阅读这些内容并生成回答。
这一套做法通常叫 RAG,Retrieval-Augmented Generation,检索增强生成。
系统收到问题后,先从资料库里找出相关内容,再把这些内容和问题一起交给模型,生成回答。
一、RAG 在解决什么问题?
大模型的知识主要来自训练数据。训练结束后,模型参数就固定了。
公司制度、产品说明、项目文档通常不在这些数据里。
如果只把问题发给模型,它可能用训练时学到的通用知识回答,也可能直接说不知道。无论哪种,都很难稳定地依据公司内部资料作答。
有人会想到把全部文档塞进提示词。文档一多,这个办法就不成立了。模型一次能接收的内容有上限,上下文窗口装不下整座资料库。
RAG 换了一种做法:不把所有资料一次性交给模型,而是先找出和当前问题相关的部分,再送给模型阅读。
可以把它理解成开卷考试。模型不是把整座图书馆背下来,而是先找到相关页,再根据这些页作答。
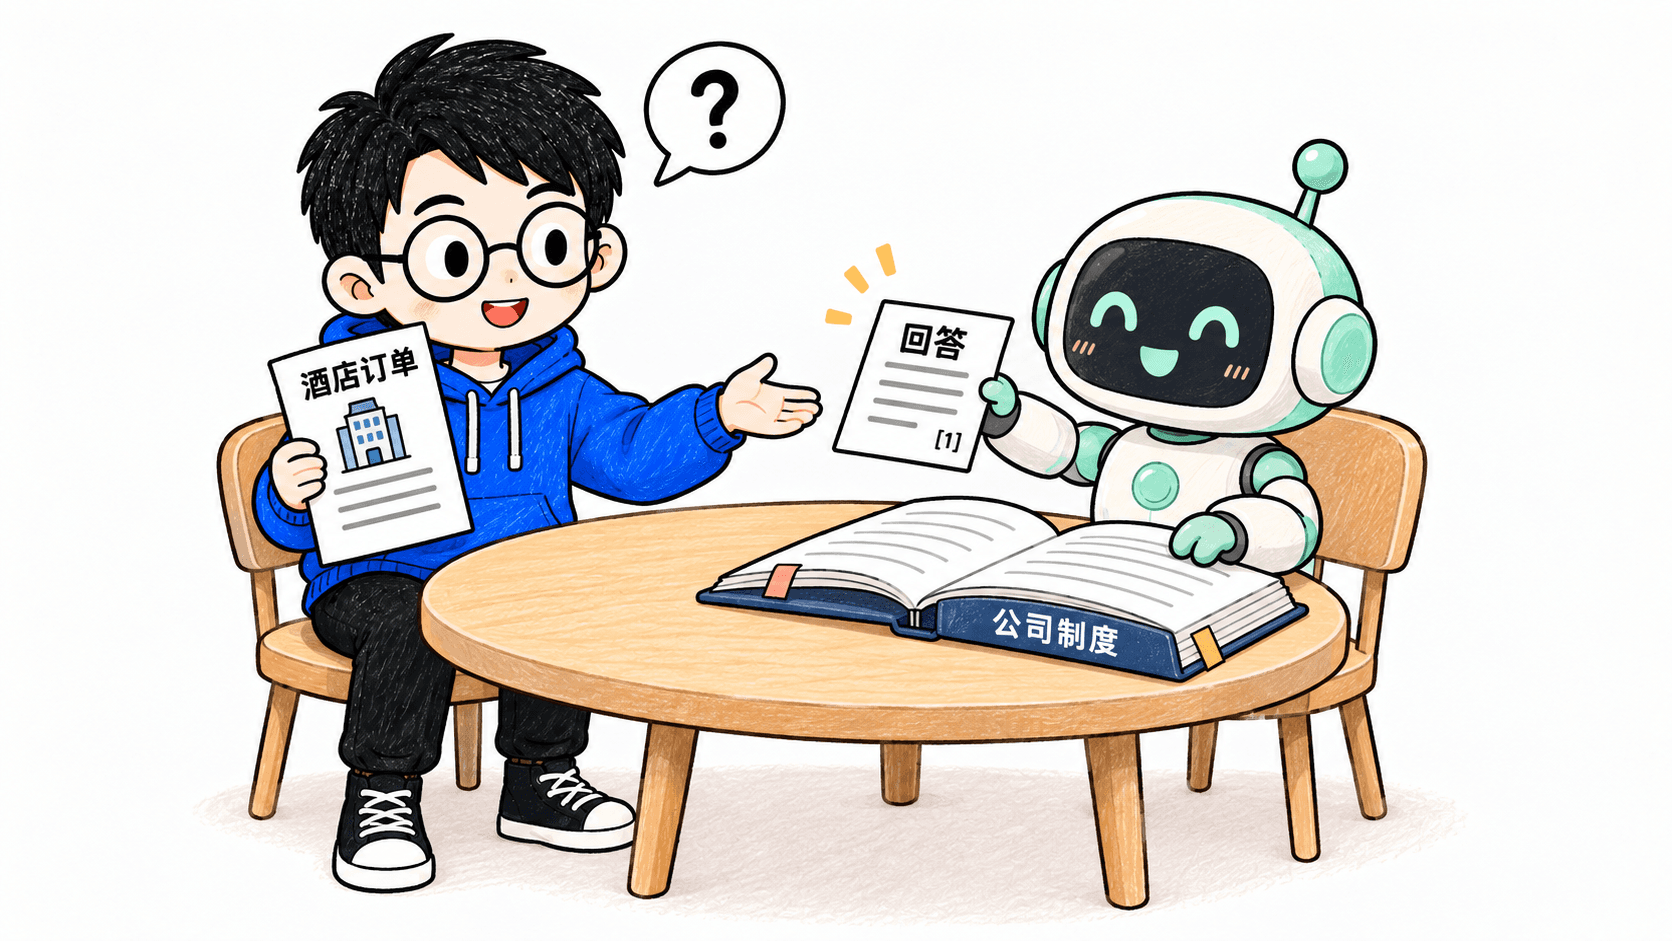
一次完整问答通常分成资料准备、检索、生成三步。
二、资料准备:把文档变成可查找的资料库
这一步发生在用户提问之前。文档不会原样整份丢进模型,而会先被整理成便于查找的形式。
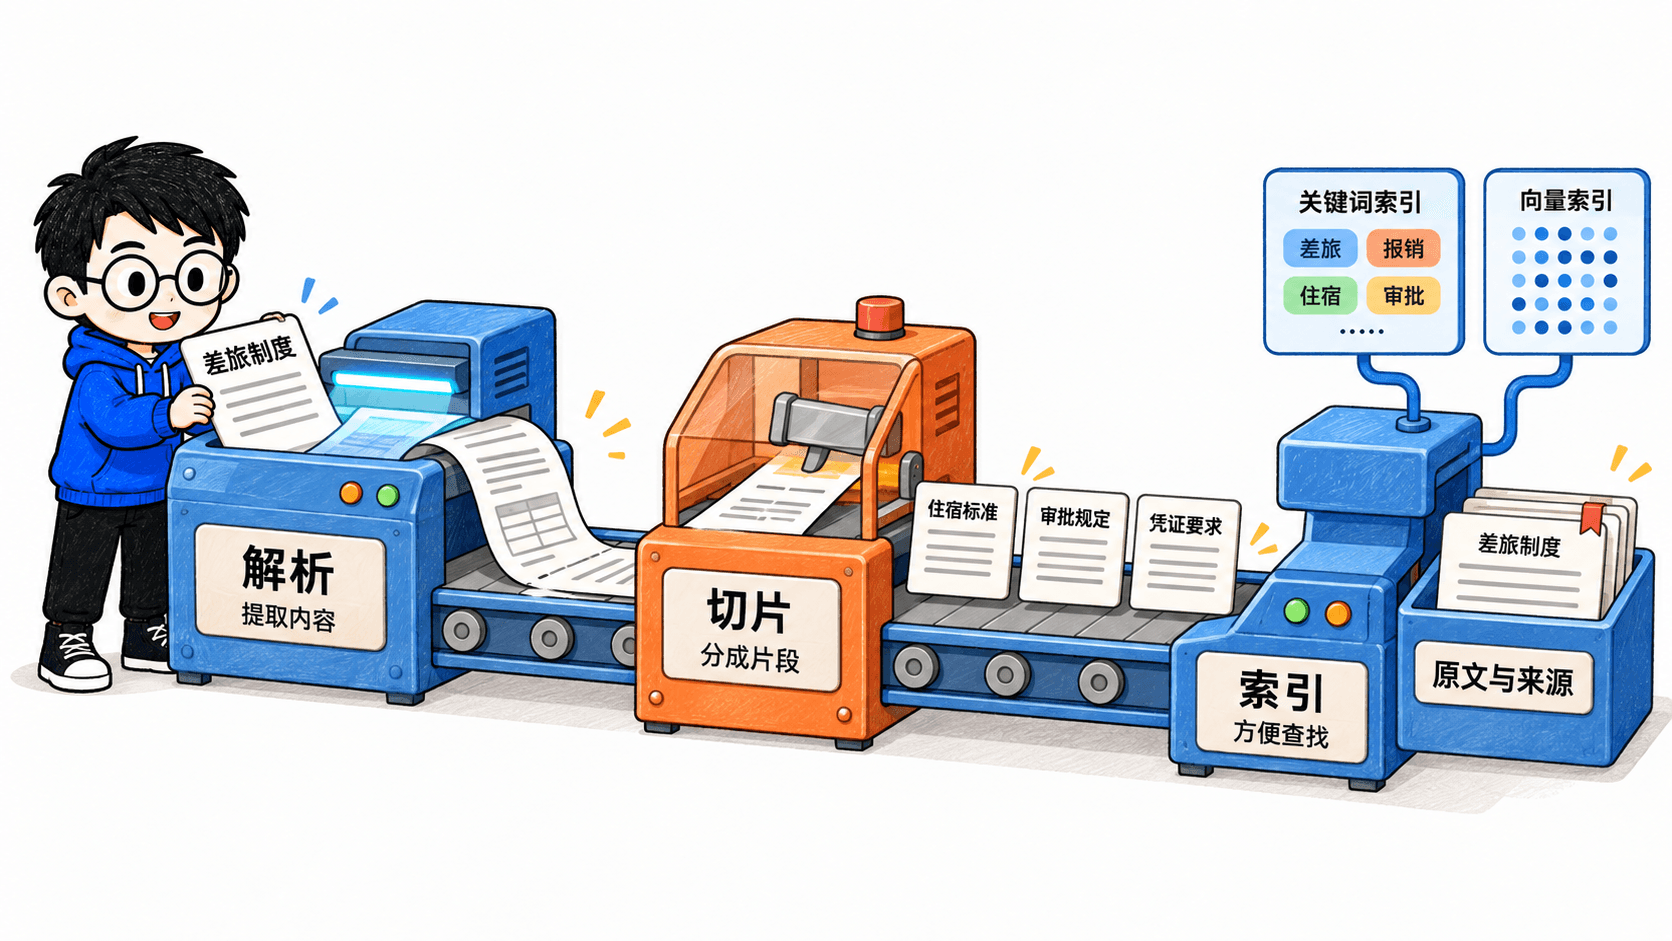
常见处理是:清洗格式、按段落或固定长度切分,再为每个切片生成向量。
切片后,系统里通常会同时保存原文和对应向量。原文用于稍后给模型阅读,向量用于判断两段文字是不是在说相近的事情。
为什么需要切分?因为整份文档往往太长。切成小段后,检索时可以只取出真正相关的几段,而不是整份文件。切分也不能太碎。切得太碎,单独一段可能缺少必要背景,模型读完也不容易判断它在讲什么。
向量可以理解成一组数字,用来表示这段文字的含义。意思接近的段落,对应的数字组合也会比较接近。
原文仍然需要保存。向量用来帮助查找,取回的原文才是模型回答时阅读的资料。
三、检索:根据问题找出相关资料
用户提问后,系统不会把资料库全部交给模型,而是先找出相关内容。
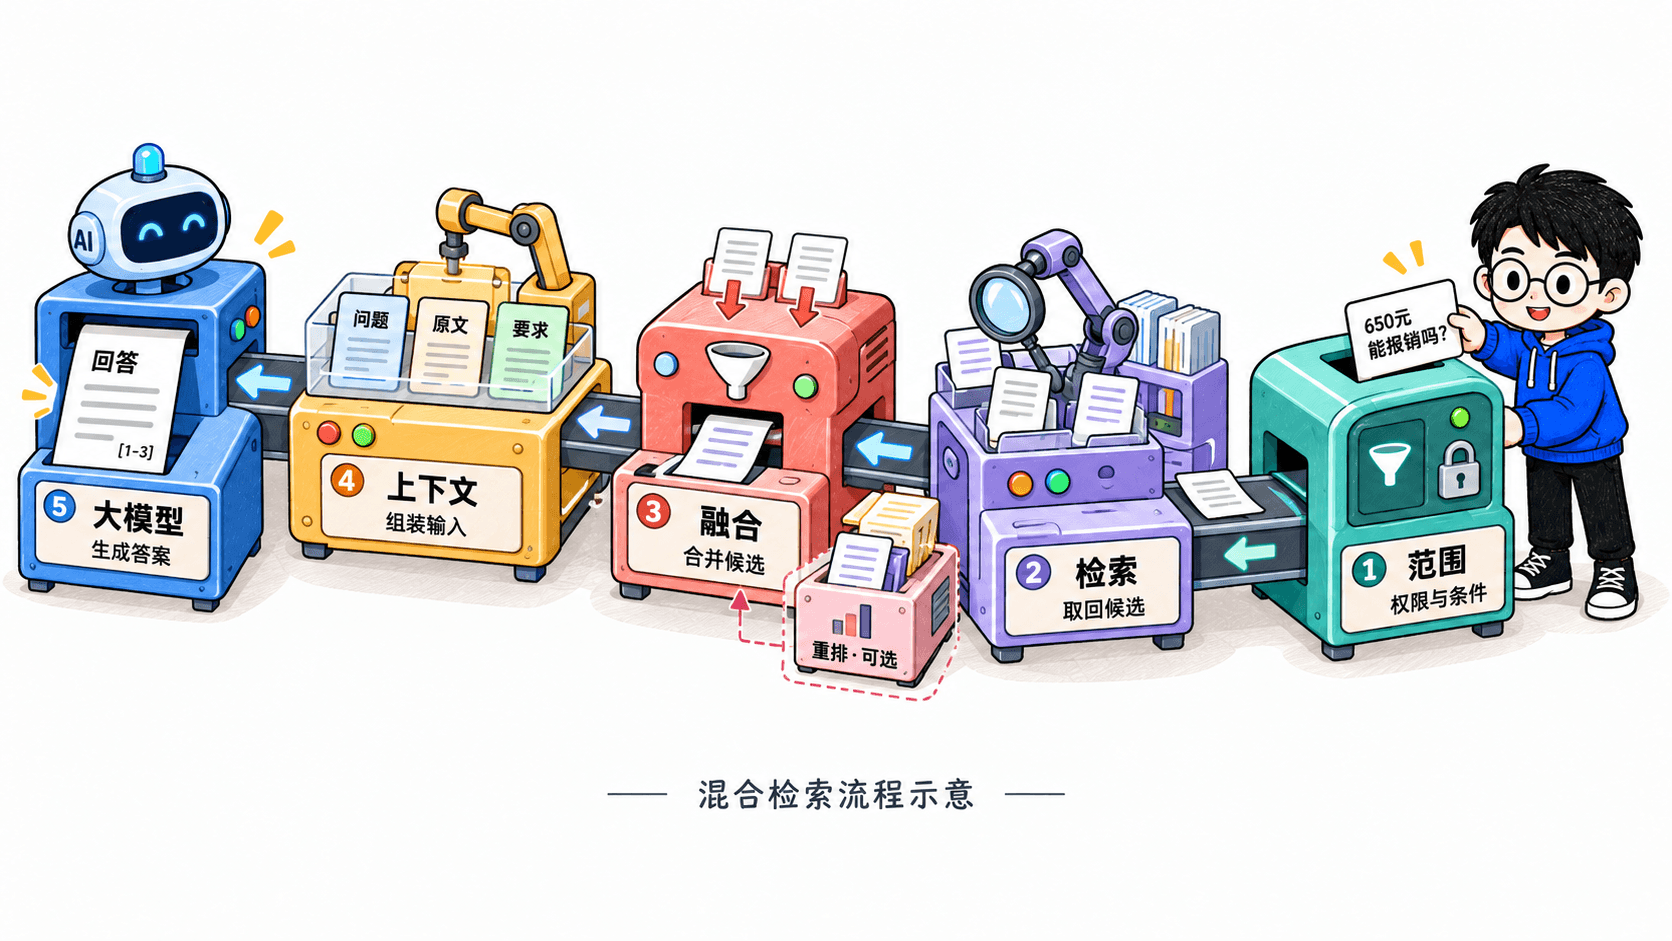
常见路径是:问题先变成向量,再在资料库里找含义接近的切片,取出原文交给模型。
这一步对应的是向量检索。它的优点是能按意思查找。用户说“出差住宿怎么报销”,资料里写的是“差旅费中的酒店费用报销规则”,字面不同,意思接近,仍然可能被找到。
向量检索也有盲区。它看的是整体含义是否接近,不保证某个具体编号、条款名或产品型号一定被命中。用户问“制度 A-12 怎么规定”,如果系统只按意思去找,可能找到不少差旅相关段落,却找不到编号就是 A-12 的那一条。
关键词检索走的是另一条路。它按字面匹配,适合找编号、条款名、产品型号这类需要精确对上的内容。用户问“制度 A-12”,它找的就是资料里有没有出现 A-12。
代价是换一种说法就可能找不到。资料写的是“差旅费中的酒店费用”,用户问“出差住宿怎么报销”,字面对不上,关键词检索可能直接落空。
所以常见系统不会只选一种。向量检索负责找意思接近的内容,关键词检索负责抓编号、条款名和产品型号,再把两边的结果合并,去交给模型。
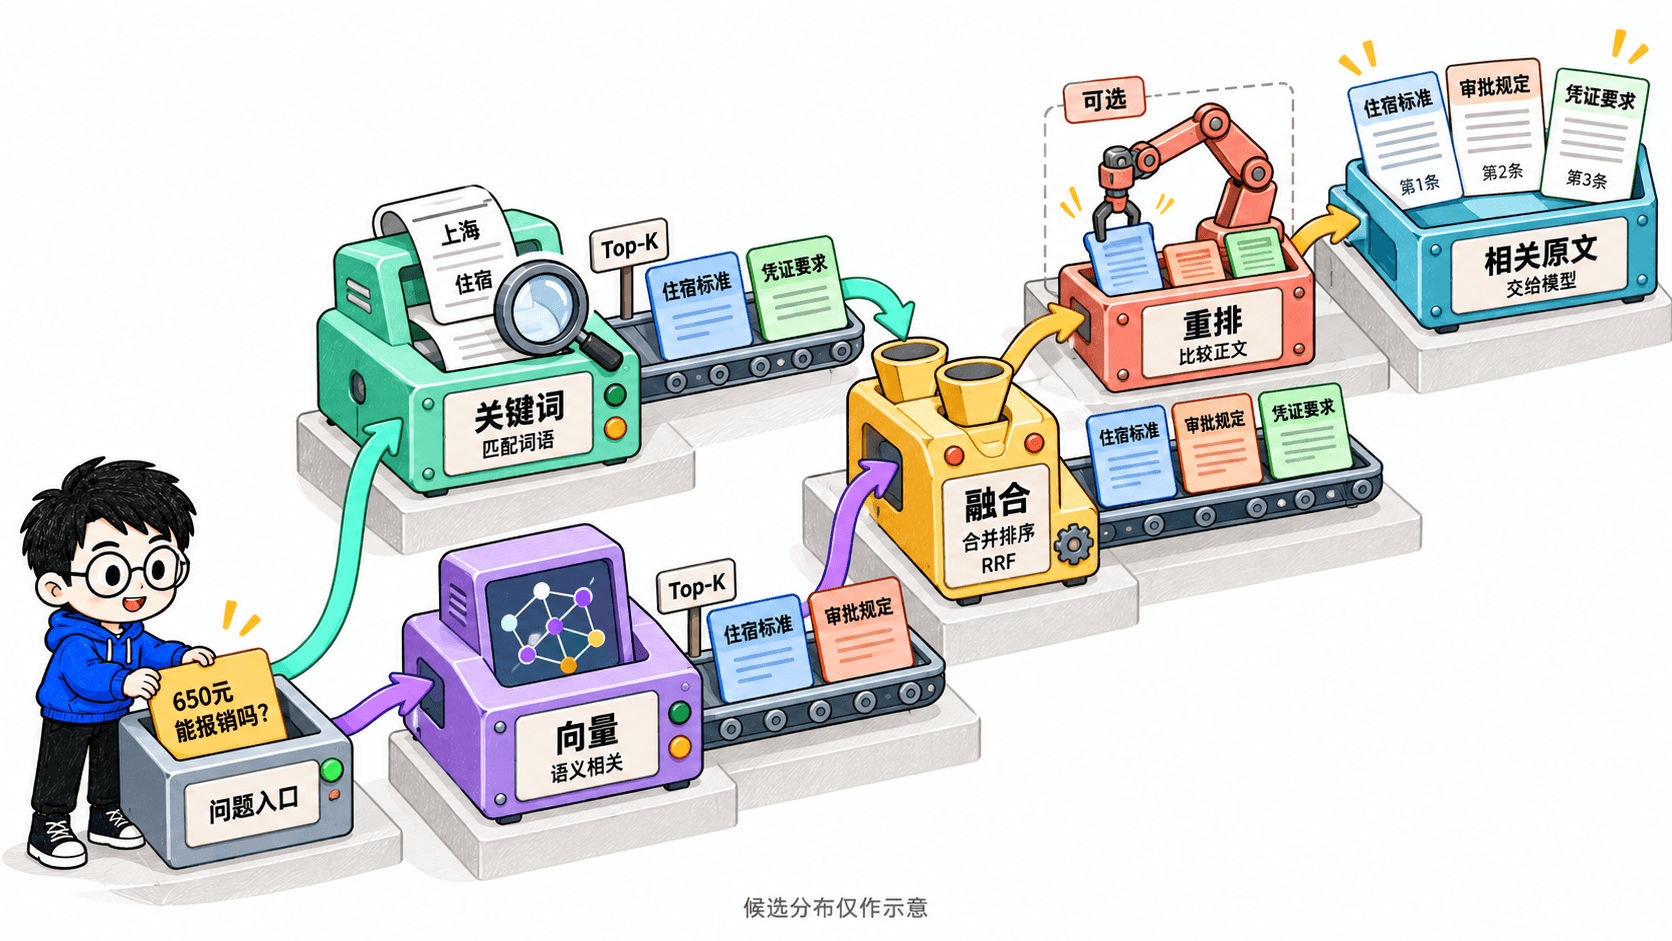
如果一定要先选一种,可以按问题类型来。问的是意思,比如“出差住宿怎么报销”,向量检索通常更合适。问的是编号、条款名或产品型号,比如“制度 A-12 怎么规定”,关键词检索更直接。两种需求都会出现时,再上混合检索。
四、生成:模型阅读资料后回答
检索结束后,系统会把用户的问题和取回的原文一起交给模型。
模型在这一步阅读这些内容,再组织成回答。也就是说,生成依据的是取回的原文,不是资料库里的向量。
资料从资料库进入模型,靠的是检索。没有被取回的内容,模型这一轮就看不到,也就无法当作依据。
回答质量不只取决于模型本身,也取决于检索有没有把真正相关的内容找出来。相关段落没有进入这一轮输入,模型再强也写不出依据这些资料的回答。
五、怎么判断这套办法够不够用?
如果目标只是让 AI 根据已有文档回答问题,RAG 通常是合适的起点。文档更新后重新入库,系统就可以按新资料检索,不必重训模型。
它也有边界。资料本身写得含糊、过时或互相矛盾,检索再准,模型也只能基于这些内容回答。相关段落没有被取回,模型同样看不到。
如果问题需要跨很多处资料汇总,或答案依赖未写入文档的业务判断,只靠检索若干段落往往不够。
也可以换个角度看选择。文档要反复更新,且主要是按资料回答,RAG 通常更合适。变化少、格式固定、对延迟和成本很敏感,把内容放进模型输入或微调,有时更直接。需要的是持续对话中的用户偏好或长期事实,那是记忆机制的问题,不是检索几段文档就能替代的。
六、小结
RAG 的核心不是先让模型记住全部资料,而是先找到相关内容,再让模型阅读后回答。
资料准备发生在提问前。文档被切分,原文和向量一起保存。用户提问后,系统检索相关切片,把原文和问题一并交给模型。模型依据这些内容生成回答。
如果只做一件事,先确认资料能按问题被准确找出来。检索不准则生成再强也没有依据。检索稳定后,再考虑要不要引入更复杂的生成或记忆机制。